Table des matières :
- Ingress Kubernetes en 2026 : l’archivage d’ingress-nginx, ce n’est pas juste un badge « read-only »
- Cartographier l’existant : votre Ingress « standard » n’est probablement pas standard du tout
- Option 1 — Migrer vers Traefik : un contrôleur moderne, moins d’annotations magiques, plus d’objets déclaratifs
- Option 2 — Passer à Gateway API : moins de bricolage, plus de modèle (et enfin une séparation des responsabilités)
- Plan de migration « zéro drama » : double exposition, canary, tests de charge, et sécurité (la vraie)
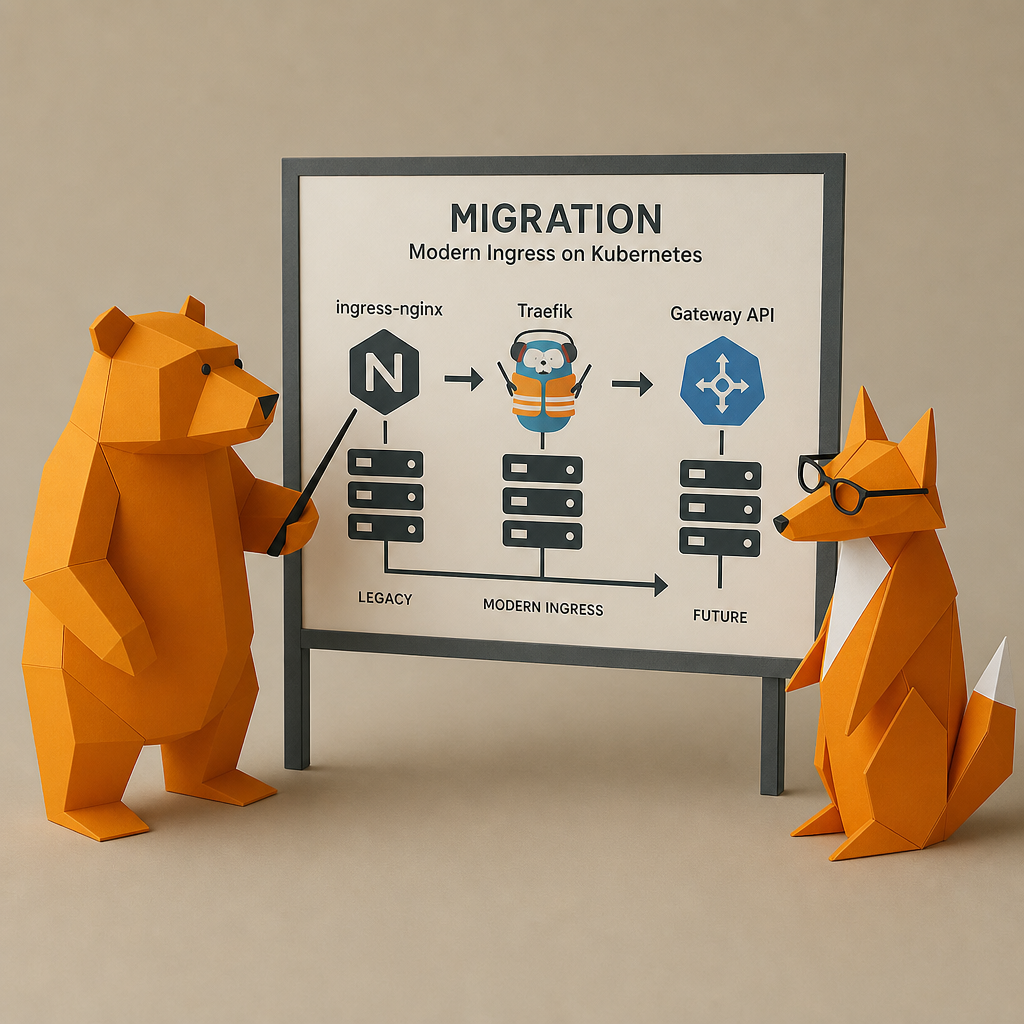
- Choisir entre Traefik et Gateway API : critères qui comptent vraiment (spoiler : pas la guerre de chapelles)
Ingress Kubernetes en 2026 : l’archivage d’ingress-nginx, ce n’est pas juste un badge « read-only »
Quand ingress-nginx (le contrôleur Ingress “de facto” de beaucoup de clusters) passe en mode archivé, ce n’est pas un détail cosmétique sur GitHub : c’est un signal opérationnel. Un dépôt archivé signifie typiquement : moins de correctifs, moins de revue, moins de maintenance sur les dépendances, et un temps de réaction incertain face aux vulnérabilités. Pour des plateformes e-commerce, SaaS ou B2B où l’edge L7 est littéralement la porte d’entrée, le risque n’est pas théorique : c’est une question de SLA, d’exposition CVE et de capacité à investiguer vite (logs, métriques, traces) quand ça brûle.
Petit rappel utile (parce qu’on a tous déjà dû l’expliquer à un manager pressé) : l’API Ingress est volontairement minimaliste. Kubernetes définit Ingress ainsi : “Ingress exposes HTTP and HTTPS routes from outside the cluster to services within the cluster.” (documentation officielle Kubernetes : https://kubernetes.io/docs/concepts/services-networking/ingress/). Le contrôleur, lui, fait tout le boulot réel. Résultat : vous n’avez pas “Kubernetes Ingress”, vous avez “Kubernetes Ingress + un contrôleur X + ses extensions”. Migrer, c’est donc migrer un comportement (et des hypothèses implicites), pas seulement une ressource.
Deux confusions fréquentes à clarifier dès le début d’un plan de migration :
- Ingress ≠ Ingress Controller : la ressource
Ingressn’est qu’une intention ; le contrôleur décide du matching, du TLS, des redirections, des headers, des timeouts, etc. - ingress-nginx ≠ NGINX Ingress Controller (commercial/éditeur) : les noms se ressemblent, les comportements ne sont pas identiques, et les chemins de support non plus. Ne partez pas du principe “c’est NGINX donc c’est pareil”.
Et comme souvent, l’enjeu n’est pas “est-ce que ça marche”, mais “est-ce que ça marche pareil sous charge, en incident, et en mode parano (TLS, WAF, headers, IP client, rate limit)”. Si vous avez déjà fait un durcissement sérieux, vous savez que le reverse proxy est un composant sécurité autant qu’un composant réseau.
Un indicateur simple (et actionnable) pour juger l’urgence : avez-vous une chaîne de patch qui inclut le contrôleur Ingress (image, chart, CRDs, admission webhook) avec une fenêtre de déploiement réaliste ? Si la réponse est “on verra au prochain sprint”, l’archivage n’est plus un “badge”, c’est une dette. Pour une checklist pragmatique côté sécu K8s, vous pouvez recouper avec Sécurisation Kubernetes : plan d’action 30 jours pour PME.
Cartographier l’existant : votre Ingress « standard » n’est probablement pas standard du tout
Avant de choisir Traefik ou Gateway API, commencez par faire l’inventaire de ce que vous utilisez réellement. Dans beaucoup de clusters, l’Ingress « simple » est un mythe : on a des annotations nginx.ingress.kubernetes.io/* partout (rewrite, timeouts, body size, websockets, auth, snippets). Et le jour où vous en oubliez une, vous découvrez en prod que votre panier WooCommerce ne passe plus parce que la taille de requête dépasse proxy-body-size.
La méthode propre : exportez tous les Ingress et faites une matrice “fonction → annotation → effet → équivalent cible”. Un premier balayage utile (par namespace) :
kubectl get ingress -A -o yaml > all-ingress.yaml

# Exemples rapides pour repérer les annotations ingress-nginx
yq '.items[].metadata.annotations | keys | .[]' all-ingress.yaml \
  | grep -E '^nginx\.ingress\.kubernetes\.io/' \
  | sort | uniq -c | sort -nr | head
Ensuite, vérifiez les comportements implicites (ceux qui cassent sans prévenir) :
- gestion de l’IP cliente (
X-Forwarded-For, headerForwarded, PROXY protocol,use-forwarded-headers), - redirections HTTP→HTTPS, HSTS, ciphers, TLS 1.3,
pathType(Prefix/Exact/ImplementationSpecific) et sémantique de matching (souvent différente entre contrôleurs),- sticky sessions, timeouts upstream, retries,
- limites (rate limiting, conn limiting),
- access logs (format, présence des headers, corrélation
request_id), - intégration cert-manager et renouvellement des certificats,
ingressClassNameet la réalité du multi-ingress (clusters partagés, environnements parallèles).
Une mini-table de cartographie (à adapter) permet d’éviter les oublis “invisibles” :
| Besoin applicatif | ingress-nginx (exemple) | Traefik (souvent) | Gateway API (standard / dépendant contrôleur) |
|---|---|---|---|
| Redirection HTTP→HTTPS | force-ssl-redirect |
middleware redirectScheme ou redirection d’entrypoint |
filtre RequestRedirect (standard) |
| Réécriture de chemin | rewrite-target |
stripPrefix, replacePathRegex (middlewares) |
filtre URLRewrite (standard, selon support) |
| Limite taille body | proxy-body-size |
middleware buffering.maxRequestBodyBytes |
souvent policy spécifique |
| Allowlist IP | whitelist-source-range |
middleware ipWhiteList |
souvent à traiter via LB / NetworkPolicy / contrôleur |
| Basic auth | auth-type: basic |
middleware basicAuth |
rarement “standard”, dépendant de l’implémentation |
Sur la partie protocoles et TLS, beaucoup d’équipes découvrent tard que “ça marchait” ne veut pas dire “c’était optimisé”. Si vous avez des exigences HTTP/2, HTTP/3/QUIC ou un durcissement TLS sérieux, recoupez avec NGINX : maîtriser HTTP/2, HTTP/3 QUIC et TLS 1.3. Même si vous quittez NGINX en tant que contrôleur, vos objectifs réseau, eux, ne disparaissent pas.
Enfin, mesurez l’existant. Pas “on pense que”. Mesurez. Latence p50/p95/p99 au niveau edge, taux d’erreurs 4xx/5xx, resets TCP, temps de handshake TLS, saturation CPU/mémoire du contrôleur, nombre de reloads/config regenerations par minute. Prometheus est votre ami (et vos alertes vous diront si vous vivez dans le déni) : https://www.les-vikings.fr/article/prometheus-architecture-monitoring-promql-alertmanager-et-grafana/.
Option 1 — Migrer vers Traefik : un contrôleur moderne, moins d’annotations magiques, plus d’objets déclaratifs
Traefik, c’est l’approche “cloud-native edge router” : découverte dynamique, configuration déclarative, et une ergonomie correcte si vous acceptez de sortir de la religion “tout se fait en annotations Ingress”. Techniquement, Traefik peut consommer soit des ressources Ingress (API standard), soit ses propres CRDs (IngressRoute, Middleware, TLSOption, etc.). La doc officielle est ici : https://doc.traefik.io/traefik/.
Le point clé : si vous migrez “Ingress → Ingress” avec Traefik, vous perdez naturellement les annotations spécifiques à ingress-nginx. Si vous migrez “Ingress → CRDs Traefik”, vous regagnez des fonctionnalités (middlewares en chaîne, règles plus fines, routes explicites), mais vous introduisez un lock-in CRD (assumé, mais réel).
Un exemple typique : la réécriture d’URL.
# Avant (ingress-nginx)
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: app
  annotations:
    nginx.ingress.kubernetes.io/rewrite-target: /$1
spec:
  rules:
  - host: app.example.com
    http:
      paths:
      - path: /api/(.*)
        pathType: ImplementationSpecific
        backend:
          service:
            name: api
            port:
              number: 80
Avec Traefik CRD, vous allez plutôt faire :
apiVersion: traefik.io/v1alpha1
kind: IngressRoute
metadata:
  name: app
spec:
  entryPoints:
    - websecure
  routes:
  - match: Host(`app.example.com`) && PathPrefix(`/api/`)
    kind: Rule
    services:
    - name: api
      port: 80
    middlewares:
    - name: strip-api
---
apiVersion: traefik.io/v1alpha1
kind: Middleware
metadata:
  name: strip-api
spec:
  stripPrefix:
    prefixes:
      - /api
Trois implications opérationnelles (celles qui font mal si on les ignore) :
1) Gouvernance : qui a le droit de créer des Middlewares partagés (auth, allowlist IP, rate limit) ? Sans garde-fous, un middleware “global” devient vite un point de fragilité ou un outil de contournement.
2) Sécurité d’exposition : Traefik est souvent déployé avec dashboard/metrics. Verrouillez RBAC, limitez l’accès réseau (NetworkPolicies), et évitez de publier une UI d’admin sur le même plan d’exposition que vos apps.
3) IP cliente et headers de confiance : selon votre cloud/LB (AWS NLB en ProxyProtocol, GKE, Azure, OVHcloud/Scaleway, etc.), l’IP source peut être masquée. La migration est le bon moment pour décider qui a le droit d’écrire X-Forwarded-For et Forwarded, et depuis quelles IPs on “fait confiance”.
Sur ce dernier point, la norme existe et rappelle l’intention :
“The ‘Forwarded’ HTTP header field is used to disclose information forwarded by proxies that is relevant to the processing of a request.” — RFC 7239 (2014), https://www.rfc-editor.org/rfc/rfc7239
Enfin, l’observabilité : Traefik exporte des métriques Prometheus et peut s’intégrer à un pipeline de traces selon votre stack. Si vous êtes en train d’unifier logs/métriques/traces, alignez ça avec OpenTelemetry : unifier métriques, traces et logs pour l’observabilité.
Option 2 — Passer à Gateway API : moins de bricolage, plus de modèle (et enfin une séparation des responsabilités)
La Gateway API est le chemin “propre” que l’écosystème Kubernetes pousse depuis plusieurs années : un modèle plus expressif qu’Ingress, pensé pour l’extensibilité, le multi-tenant, et des politiques plus claires (site officiel : https://gateway-api.sigs.k8s.io/). L’idée n’est pas de “déclarer la mort d’Ingress”, mais de sortir du piège historique : compenser une API minimaliste par des annotations hétérogènes selon le contrôleur.
Conceptuellement, Gateway API découpe le problème en objets :
- GatewayClass : le type de contrôleur (et sa config globale),
- Gateway : le point d’entrée (listeners, ports, TLS),
- HTTPRoute / TLSRoute / TCPRoute / GRPCRoute : les règles de routage,
- ReferenceGrant : les permissions cross-namespace (parce que l’isolation, ce n’est pas un slogan).
Cette séparation est un vrai gain : la team plateforme gère les Gateways, la team applicative gère ses HTTPRoutes. C’est particulièrement utile sur des organisations “plateforme + squads” (cas courant en ESN/scale-ups, mais aussi dans des ETI françaises qui mutualisent un cluster par BU).
Un exemple minimaliste “Ingress → Gateway API” pour un host + path prefix :
apiVersion: gateway.networking.k8s.io/v1
kind: Gateway
metadata:
  name: public-gw
  namespace: edge
spec:
  gatewayClassName: envoy-gateway
  listeners:
  - name: https
    port: 443
    protocol: HTTPS
    hostname: app.example.com
    tls:
      mode: Terminate
      certificateRefs:
      - kind: Secret
        name: app-tls
---
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: app-route
  namespace: app
spec:
  parentRefs:
  - name: public-gw
    namespace: edge
  hostnames:
  - app.example.com
  rules:
  - matches:
    - path:
        type: PathPrefix
        value: /api
    backendRefs:
    - name: api
      port: 80
Deux points très concrets à ajouter à vos critères de choix (au-delà du YAML) :
- Quel contrôleur Gateway API ? Gateway API est une spécification ; le comportement exact dépend de l’implémentation (Envoy Gateway, Istio, Kong, HAProxy, etc.). L’API standardise le modèle, pas chaque feature L7 “enterprise”.
- Quelles features sont conformes vs “best effort” ? Certaines capacités (p. ex. politiques de rate limiting avancées, WAF, mTLS upstream, authn/authz) sont souvent apportées via des CRDs “Policy” spécifiques au contrôleur.
Là encore, la réalité rattrape vite la théorie : les fonctionnalités avancées (rate limit, WAF, auth, retries, timeouts, mTLS upstream) passent souvent par des Policy CRDs spécifiques à l’implémentation. Gateway API rend la plateforme plus gouvernable… mais ce n’est pas magique.
Plan de migration « zéro drama » : double exposition, canary, tests de charge, et sécurité (la vraie)
La stratégie qui évite les nuits blanches : run en parallèle.
1) Déployez Traefik ou un contrôleur Gateway API à côté de l’ancien ingress-nginx, sur un autre Service/LoadBalancer (ou une autre IP). 2) Reproduisez d’abord les routes “simples” (host/path, TLS, redirections), puis les comportements “piégeux” (rewrite, headers, body size, websocket). 3) Basculez par DNS (pondération, TTL court) ou mieux : via un LB en amont / mécanisme de canary (header, cookie, pourcentage).
Ensuite, testez comme des adultes. Pas “curl marche depuis mon laptop”. Testez :
- fonctionnel : chemins, redirects, auth, cookies, uploads, websockets, gRPC si applicable,
- performance : p95/p99, débit, saturation, backpressure (files d’attente, timeouts),
- résilience : pods qui meurent, endpoints qui changent, rolling update du contrôleur, renouvellement de certificats,
- sécurité : headers de confiance, injection de
X-Forwarded-*/Forwarded, bypass auth, TLS config, HSTS, exposition involontaire d’admin endpoints.
Un mini-scénario très réel (vu sur des stacks en France, typiquement en régions cloud Paris/Marseille ou on-prem) : vous basculez le contrôleur, et d’un coup votre application “voit” toutes les requêtes venir de l’IP du LoadBalancer. Résultat : rate limiting applicatif inutile, logs d’audit incohérents, règles de sécurité (allowlist) cassées. Dans ce cas, la question n’est pas “Traefik vs Gateway API”, c’est : où est terminée la connexion et où est construite l’identité client (source IP + proto + SNI + headers) ?
Si votre plateforme prend des pics de trafic (campagnes, Black Friday, newsletter), la migration d’ingress est un des meilleurs moyens de découvrir que votre infra n’était pas prête. Pour cadrer la partie capacité/anti-effet de bord e-commerce, recoupez avec WooCommerce : préparer l’infrastructure aux pics de trafic et campagnes.
Côté observabilité, fixez des SLO avant de toucher au DNS. Par exemple :
| Indicateur | Objectif (exemple) | Source |
|---|---|---|
| Taux de réponses 5xx | < 0,1% | métriques ingress/controller + app |
| Latence p95 | < 300 ms | métriques edge + APM |
| Erreurs TLS handshake | stable / pas de hausse | métriques LB/controller |
| Ratio 499/timeout | pas de hausse | logs d’accès |
Instrumentez votre nouveau contrôleur (métriques, logs d’accès structurés, traces si possible), et préparez un rollback automatisable (pas “on repointe le DNS à la main”). Le couple Prometheus + Alertmanager est parfait pour déclencher une bascule arrière si les budgets d’erreurs explosent (voir https://www.les-vikings.fr/article/prometheus-architecture-monitoring-promql-alertmanager-et-grafana/). Et si vous déployez via GitOps, assurez-vous que vos manifests ingress ne peuvent pas dériver en prod : un pipeline propre et signé, ça se prépare (utile : Pipeline CI/CD Kubernetes : GitHub Actions et Argo CD étape par étape).
Choisir entre Traefik et Gateway API : critères qui comptent vraiment (spoiler : pas la guerre de chapelles)
Si vous voulez une réponse tranchée : Gateway API est souvent le meilleur investissement long terme pour une plateforme Kubernetes “produit” (multi-équipes, gouvernance, évolutivité des règles). Traefik est souvent le meilleur accélérateur court terme si vous voulez remplacer ingress-nginx avec une friction limitée et une doc d’exploitation accessible.
Les deux peuvent coexister : Traefik peut couvrir des cas simples (ou des environnements “petites équipes”), pendant qu’un contrôleur Gateway API gère le plus “policy-driven” (multi-tenant, séparation stricte, routes complexes). L’important est de décider explicitement ce que vous standardisez : le modèle (Gateway API) ou un produit (Traefik et ses CRDs).
Les critères rationnels :
1) Portabilité : Gateway API vise une portabilité des concepts. Les CRDs Traefik sont efficaces, mais vous lient davantage (même si c’est parfois un trade-off parfaitement acceptable).
2) Séparation des rôles : Gateway API est faite pour ça (Gateway vs Route). Traefik peut le faire via RBAC + namespaces + conventions, mais ce n’est pas “dans le modèle”.
3) Fonctionnalités avancées : Traefik brille avec ses Middlewares. Gateway API dépend beaucoup du contrôleur choisi et de ses Policy CRDs : excellent si vous assumez ce choix, moins si vous voulez rester “agnostique”.
4) Maturité opérationnelle : regardez la qualité des métriques, la gestion des upgrades (CRDs incluses), la compatibilité avec votre CNI/LB, et la réaction aux vulnérabilités. En France, c’est aussi là que se joue le pragmatisme : un cluster en AWS eu-west-3 (Paris), Azure France Central, GCP europe-west9 (Paris), OVHcloud ou Scaleway n’a pas toujours les mêmes comportements LB (health checks, PROXY protocol, idle timeouts). L’edge n’est pas “juste du YAML”, c’est une intégration complète à votre environnement.
Enfin, n’oubliez pas les sujets que tout le monde remet “à plus tard” : DDoS, WAF, rate limiting, cache, et edge hardening. Parce qu’un Ingress, c’est aussi une surface d’attaque. Pour cadrer la protection en amont (CDN/anti-DDoS), vous avez Protection DDoS cloud 2026 : comparatif des 12 meilleures solutions.
Si vous voulez industrialiser la migration (audit d’annotations, plan de bascule, SLO, et durcissement), et éviter le classique “on migre vendredi 18h”, vous pouvez passer par une équipe DevOps qui fait ça pour de vrai : https://www.les-vikings.fr/groupe-vikings-technologies-tous-nos-domaines-intervention/societe-hebergement-e-commerce-web-hebergeur-vert/devops-creation-et-optimisation-dinfrastructures-dhebergement/ — ou tout simplement nous écrire : https://www.les-vikings.fr/contact-vikings-technologies-adresse-telephone-mail-lyon-saint-genis-laval/.