Table des matières :
- OAuth 2.0 Google côté serveur Web : un flux adapté aux applications web avec back-end
- Préparer Google Cloud correctement (oui, c’est déjà une surface d’attaque)
- Déroulé du flux Authorization Code (avec PKCE) : les échanges HTTP sans folklore
- Sécuriser l’application : state, sessions, cookies et stockage des tokens (le vrai boulot)
- Points de contrôle cryptographiques : valider l’id_token comme un adulte
- Durcissement infra : TLS, reverse-proxy, WAF et observabilité (parce que le réseau existe)
- Exploitation en production : rotation, révocation, erreurs et CI/CD (là où tout casse)
- Check-list de mise en prod (et comment éviter de vous faire corriger en audit)
OAuth 2.0 Google côté serveur Web : un flux adapté aux applications web avec back-end
Quand on parle d’OAuth 2.0 Google, beaucoup d’équipes pensent encore « bouton Sign in with Google = magie ». Spoiler : ce n’est pas de la magie, c’est une série d’URL, de jetons et de paramètres qui n’attendent qu’une seule chose : être mal implémentés. Pour une appli web classique (back-end capable de garder un secret), le flux serveur Web correspond au Authorization Code Grant (réponse code), idéalement renforcé par PKCE. C’est un flux adapté pour éviter de balancer des tokens dans le navigateur comme on distribue des flyers.
La définition officielle vaut mieux que 15 slides de “SSO pour les nuls”. Le RFC 6749 (OAuth 2.0) pose le cadre :
“The OAuth 2.0 authorization framework enables a third-party application to obtain limited access to an HTTP service…” — RFC 6749, Abstract (consulter le RFC 6749)
Autrement dit : vous déléguez un accès limité, et vous devez contrôler ce que vous déléguez. Et si votre besoin est l’authentification (identifier un utilisateur), vous êtes en réalité sur le territoire d’OpenID Connect (OIDC), qui ajoute une couche “identité” au-dessus d’OAuth.
“OpenID Connect 1.0 is a simple identity layer on top of the OAuth 2.0 protocol.” — OpenID Connect Core 1.0 (consulter la spécification OpenID Connect Core 1.0)
Donc : OAuth pour l’autorisation, OIDC pour l’authentification (via id_token). Et non, « récupérer l’email via une API Google » n’est pas une stratégie d’authentification robuste.
Dernier point souvent négligé : Google a sa documentation “web server” (naming, endpoints, paramètres) et elle est utile pour éviter les approximations qui cassent en prod : documentation Google OAuth 2.0 pour les applications Web côté serveur. Ce n’est pas un substitut aux RFC, mais c’est une source fiable pour les spécificités Google.
Préparer Google Cloud correctement (oui, c’est déjà une surface d’attaque)
Une implémentation sécurisée du flux serveur Web commence… avant d’écrire du code. Dans Google Cloud Console, vous allez configurer l’écran de consentement et créer des identifiants OAuth. Deux erreurs vues en audit plus souvent qu’un SELECT * en prod : (1) scopes trop larges “au cas où”, (2) redirect URIs approximatives “on verra après”. Dans OAuth, “on verra après” se traduit souvent par “incident de sécurité” et “post-mortem”.
Côté écran de consentement, anticipez aussi les points “organisationnels” qui deviennent vite des problèmes techniques :
- Type d’application (interne vs externe) : en entreprise, un écran “interne” peut simplifier si vous restez dans un domaine Google Workspace. Si vous êtes “externe”, votre cycle de publication et de validation peut devenir un jalon projet à part entière.
- Domaines autorisés : vérifiez que les domaines utilisés pour les informations de l’application (comme sa page d’accueil et sa politique de confidentialité) sont bien déclarés et maîtrisés. Cette configuration est distincte de la liste des URI de redirection autorisées.
- Environnements : si vous avez
staging,preprod,prod, ne les mélangez pas dans un même client OAuth “par confort”. Un redirect URI de staging laissé actif = un chemin de contournement qui traîne.
Côté credentials, pour un back-end, choisissez un client OAuth de type Web application (client confidentiel). Déclarez des Redirect URIs strictes (HTTPS en production, pas de wildcard, pas de domaine staging qui pointe sur une instance oubliée). Le redirect URI est un contrôle de sécurité : s’il est trop permissif, vous ouvrez la porte à des attaques de redirection et à l’exfiltration de code.
Exemple concret (erreur fréquente) : si vous enregistrez https://app.exemple.com/oauth/google/callback mais que votre code utilise https://app.exemple.com/oauth/google/callback/ (slash final), vous venez de vous créer un bug “aléatoire” (et souvent un redirect_uri_mismatch) qui finira en contournement “temporaire” du genre on autorise les deux — c’est précisément ce qu’on veut éviter.
Côté scopes, soyez minimalistes : pour un login, openid email profile suffit généralement. Ajoutez ensuite uniquement les scopes nécessaires aux API Google que vous appelez réellement (Drive, Calendar, etc.). Plus vous demandez, plus vous augmentez (a) la friction utilisateur, (b) les contraintes de validation Google (scopes sensibles/restrictifs), (c) votre blast radius si un refresh token fuite.
Cette discipline “scopes minimaux” colle d’ailleurs très bien au cadre RGPD (pertinent dès que votre service touche des utilisateurs en France/UE) :
“adequate, relevant and limited to what is necessary in relation to the purposes for which they are processed (‘data minimisation’)” — Règlement (UE) 2016/679 (RGPD), article 5(1)(c) (consulter le règlement RGPD)
Pour recadrer l’approche “scopes buffet à volonté”, relisez votre stratégie globale de sécurité des API : Sécurité des API : authentification, autorisations et logique métier.
Déroulé du flux Authorization Code (avec PKCE) : les échanges HTTP sans folklore
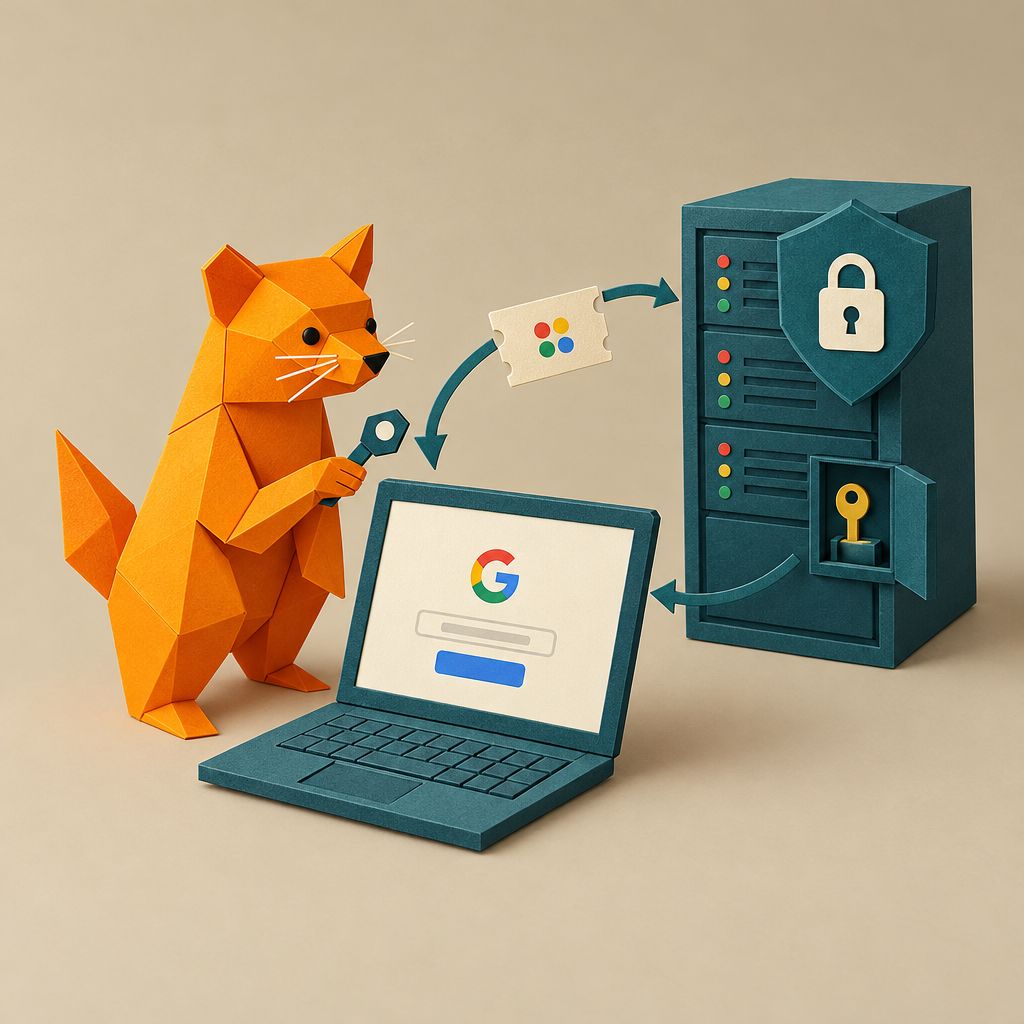
Le flux serveur Web (Authorization Code) se résume à un aller-retour contrôlé : votre serveur envoie l’utilisateur chez Google, récupère un code sur un endpoint de callback, puis échange ce code contre des tokens directement côté serveur. Le point clé : le navigateur ne doit pas être un coffre-fort. Parce que ce n’est pas un coffre-fort.
Même pour un client “confidentiel”, activer PKCE est une bonne habitude : ça limite l’impact d’un code intercepté (via log proxy, referer mal géré, extension browser douteuse, etc.). Le RFC 7636 est explicite sur le périmètre de l’extension PKCE :
“This extension is applicable to public clients using the Authorization Code grant…” — RFC 7636, Section 1 (consulter le RFC 7636)
En pratique, “applicable” n’a jamais voulu dire “interdit aux clients confidentiels”. En 2026, ne pas mettre PKCE, c’est comme désactiver la ceinture parce que votre voiture a des airbags.
Concrètement, vous construisez une URL d’autorisation (endpoint Google) avec au minimum :
GET https://accounts.google.com/o/oauth2/v2/auth?
  client_id=...&
  redirect_uri=https://app.exemple.com/oauth/google/callback&
  response_type=code&
  scope=openid%20email%20profile&
  state=...&
  nonce=...&
  code_challenge=...&
  code_challenge_method=S256&
access_type=offlinestate: protège contre les attaques CSRF ; il doit être imprévisible et lié à une session serveur. La protection contre les attaques de type mix-up nécessite aussi des mesures adaptées, comme la validation de l’émetteur ou des URI de redirection distinctes.nonce: lie l’id_tokenà la demande d’authentification et aide à prévenir sa réutilisation.code_challenge: valeur Base64URL sans padding du SHA-256 ducode_verifier(stocké côté serveur, jamais côté front).access_type=offline: nécessaire chez Google si vous visez unrefresh_token(et donc un accès long-terme, à manier avec prudence).
Deux subtilités “Google” qui surprennent en production :
- Le
refresh_tokenn’est pas garanti à chaque connexion : il est souvent renvoyé surtout lors du premier consentement. Si votre design suppose “refresh token à chaque login”, vous allez découvrir le bug… un lundi matin. Si vous avez un besoin légitime de forcer un nouveau consentement, Google documente l’usage deprompt=consent(à utiliser avec parcimonie pour éviter de dégrader l’UX). - Le
staten’est pas une formalité : c’est votre garde-fou contre les attaques CSRF. Unstateréutilisé, prévisible, ou dissocié d’une session, transforme votre callback OAuth en point d’entrée pour session swap.
Ensuite, sur votre endpoint callback, vous recevez code + state. Vous validez state, puis vous échangez code contre tokens auprès de l’endpoint de jeton de Google :
POST [endpoint de jeton de Google]
Content-Type: application/x-www-form-urlencoded

grant_type=authorization_code&
code=...&
redirect_uri=...&
client_id=...&
client_secret=...&
code_verifier=...
La réponse contient typiquement access_token, expires_in, parfois refresh_token (souvent uniquement au premier consentement), et si vous avez demandé openid, un id_token (JWT) que vous devez vérifier (signature, iss, aud, exp, nonce). Sans vérification cryptographique, votre “SSO Google” est juste un formulaire de contact avec du maquillage.
Mini-scénario (très réaliste) : une équipe logue “temporairement” l’URL complète de callback pour débugger (/oauth/google/callback?code=...&state=...). Ce log part dans un outil SaaS, accessible à 30 personnes et conservé 90 jours. Résultat : une fuite de code + state exploitable pendant quelques minutes, mais suffisante si un attaquant a accès aux logs en temps réel. Moralité : ne loguez pas les paramètres OAuth.
Sécuriser l’application : state, sessions, cookies et stockage des tokens (le vrai boulot)
Première règle : ne traitez jamais OAuth comme un simple redirect. Le paramètre state doit être généré côté serveur (128 bits aléatoires minimum), stocké dans une session serveur (ou datastore temporaire) et comparé à la valeur retournée. Si vous faites “state = timestamp” ou “state = userId”, vous n’avez pas implémenté OAuth, vous avez implémenté un mini-jeu pour pentesters.
Bon réflexe : stocker, avec state, un petit contexte serveur (TTL court) :
- l’URL de retour interne attendue (où renvoyer l’utilisateur après login),
- l’identifiant de session côté serveur,
- le
code_verifierPKCE, - le
nonce, - et éventuellement un drapeau “flow démarré à T0” (pour refuser les callbacks trop tardifs).
Deuxième règle : votre gestion de session doit être propre. Le cookie de session doit être Secure, HttpOnly, et avec un SameSite adapté (Lax est souvent un bon défaut ; None impose TLS et doit être justifié). Le callback OAuth doit être protégé contre les confusions de session : c’est l’endroit rêvé pour coller une authentification à la mauvaise session si vous ne reliez pas state à un contexte serveur strict.
Deux pratiques simples qui évitent des bugs pénibles :
- Rotation de l’identifiant de session au moment où l’utilisateur est authentifié (anti session fixation).
- Invalidation des états (
state/code_verifier) dès qu’ils ont servi (anti rejouabilité interne et anti “double-clic login”).
Troisième règle : stockage des tokens. L’access token est court-vivant (souvent ~3600 secondes), le refresh token est long-vivant (et donc une cible). En architecture web, stockez les tokens côté serveur (DB chiffrée, KMS, ou au minimum chiffrement applicatif avec rotation de clés). Évitez le localStorage (donc XSS = compromission), et évitez de renvoyer des tokens au navigateur “par confort”. Si vous avez besoin d’appeler Google depuis le front, vous avez probablement besoin d’un BFF (Backend For Frontend), pas d’un accès direct.
Table “décision rapide” (pratique en revue d’archi) :
| Besoin | Mauvaise idée | Option saine (souvent) |
|---|---|---|
| Appeler une API Google côté navigateur | Mettre access_token dans localStorage |
Appels API via votre serveur (BFF), token stocké côté serveur |
| Garder l’accès long-terme | Refresh token en clair en base | Refresh token chiffré + contrôle d’accès strict + rotation de clés |
| Débugger le flow | Logger code, state, tokens |
Logger un identifiant de corrélation, et des erreurs “sanitisées” |
Points de contrôle cryptographiques : valider l’id_token comme un adulte
Si vous utilisez OIDC (donc scope=openid), vous recevez un id_token (JWT). Et un JWT n’est pas “fiable” parce qu’il ressemble à trois strings séparées par des points. La validation minimale : vérifier la signature (clé publique Google via JWKS), vérifier iss (issuer), vérifier aud (votre client_id), vérifier exp/iat, et surtout vérifier nonce si vous l’avez envoyé.
Pour éviter les erreurs d’implémentation “à la main”, appuyez-vous sur la configuration OpenID (discovery) de Google :
- Document de découverte :
https://accounts.google.com/.well-known/openid-configuration
Ce document pointe vers lejwks_uriet les endpoints officiels. C’est utile pour limiter les URLs “hardcodées” qui finissent obsolètes.
La récupération des clés publiques se fait via endpoints Google (JWKS/certs). Techniquement, vous devez gérer le cache et la rotation des clés : vous n’allez pas refetch les certs à chaque login, sauf si vous aimez DDoS votre propre auth. Un cache mémoire avec TTL cohérent, ou mieux un cache distribué, suffit. Si votre stack est déjà équipée, Redis est un candidat naturel (et tant qu’à faire, optimisez-le correctement) : Guide d’implémentation du cache objet Redis.
Deux points de vigilance supplémentaires (souvent oubliés) :
emailn’est pas un identifiant immuable : si vous avez besoin d’un identifiant stable côté application, utilisez le claimsub(subject) de l’id_tokencomme pivot technique, puis gérez l’email comme une donnée modifiable.- Ne “faites pas confiance” au JWT parce qu’il vient de Google : faites confiance parce que vous l’avez validé (signature + claims attendus).
Ne confondez pas id_token et access_token. Le premier sert à établir l’identité de l’utilisateur dans votre app (après validation), le second sert à appeler des API au nom de l’utilisateur. Mélanger les deux mène à des implémentations où “l’utilisateur est authentifié” parce qu’un endpoint a répondu 200 une fois. En sécurité, ce genre de logique s’appelle “un futur incident”.
Durcissement infra : TLS, reverse-proxy, WAF et observabilité (parce que le réseau existe)
OAuth 2.0 Google, sans TLS strict, c’est un peu comme un coffre-fort en carton : techniquement c’est un coffre, mais bon. Forcez TLS 1.3 quand possible, activez HSTS, désactivez les suites obsolètes, et surveillez vos en-têtes (CSP, Referrer-Policy, etc.). Si votre terminaison TLS est NGINX, vous avez un guide utile ici : NGINX : HTTP/2, HTTP/3 (QUIC) et TLS 1.3.
Deux détails infra qui font une vraie différence sur OAuth/OIDC :
- Referrer-Policy : évitez de divulguer des URLs sensibles via le header
Referer(même si, idéalement, vous ne mettez jamais de tokens dans l’URL). Une politique restrictive réduit les fuites “accidentelles” vers des tiers (scripts, CDN, etc.). - No-store sur les pages sensibles : sur le callback et les écrans post-login, appliquez des en-têtes de cache adaptés (
Cache-Control: no-store) pour limiter la persistance côté navigateur/proxy.
Le reverse proxy (NGINX/HAProxy/Ingress) doit aussi gérer la protection basique : limitation de débit sur /oauth/google/callback, blocage des patterns évidents (scanners, user-agents agressifs), et journalisation propre (sans loguer code, state, ni tokens — oui, ça arrive). Pour une mise en place solide d’un proxy sécurisé : HAProxy : déployer un reverse proxy et load balancer sécurisé.
Enfin, l’observabilité : si vous ne mesurez pas votre auth, vous découvrirez les problèmes… via le support client, ce qui est un excellent moyen de ruiner une journée. Exposez des métriques : taux de succès login, erreurs invalid_grant, latence sur l’échange token, erreurs de validation JWT. Tracez le parcours (sans données sensibles) avec OpenTelemetry : OpenTelemetry : unifier métriques, traces et logs et alertez via Prometheus/Alertmanager : Prometheus, PromQL, Alertmanager et Grafana.
Exploitation en production : rotation, révocation, erreurs et CI/CD (là où tout casse)
En production, vos principaux ennemis sont rarement “les hackers hollywoodiens”. Ce sont plutôt : refresh tokens non retournés (consent déjà accordé), erreurs invalid_grant (code expiré ou déjà utilisé, redirect URI mismatch), et utilisateurs qui révoquent l’accès côté Google. Votre code doit traiter ces cas : reconnecter proprement, invalider la session locale, et surtout ne pas partir en boucle infinie de refresh. Un backoff exponentiel + circuit breaker sur l’appel token, ce n’est pas du luxe.
Prévoyez aussi le cas “produit” : l’utilisateur veut déconnecter Google. Il faut distinguer :
- la déconnexion locale (session de votre appli),
- la révocation OAuth (couper l’accès de votre appli aux API Google),
- et la déconnexion du compte Google dans le navigateur (qui ne vous appartient pas).
Google propose un endpoint de révocation, à appeler côté serveur (utile quand l’utilisateur “retire l’accès” depuis votre interface). Même si vous ne révoquez pas systématiquement (selon votre UX), au minimum vous devez savoir gérer un token devenu invalide sans dégrader l’expérience en “erreur incompréhensible”.
La rotation des secrets est non négociable : client_secret, clés de chiffrement des tokens, cookies signing keys, etc. Et évidemment, vous ne stockez pas ces secrets dans Git “parce que c’est plus simple”. Votre pipeline CI/CD est un multiplicateur d’attaque, donc sécurisez dépôts, runners et secrets : sécuriser CI/CD (dépôts, runners, secrets, artefacts) (et tant qu’à faire, approchez-le en DevSecOps plutôt qu’en “on patchera après”) : DevSecOps-as-a-Service.
Côté tests, automatisez au minimum : (1) tests d’intégration sur le callback (validation state, rejet state invalide), (2) tests de validation id_token (aud/iss/nonce), (3) tests de non-régression sur la configuration redirect URIs. Ajoutez une campagne DAST/SAST et un modèle de menace simple. Les race conditions existent aussi en auth (sessions parallèles, double-clic login, retries) : prévenir les race conditions.
Check-list de mise en prod (et comment éviter de vous faire corriger en audit)
Avant de déployer votre implémentation sécurisée du flux serveur Web OAuth 2.0 Google, passez une check-list opérationnelle. Pas une checklist “marketing” avec des verbes vagues, mais des points vérifiables : redirect URIs strictes, PKCE S256, state aléatoire et lié à une session serveur, cookies Secure/HttpOnly, validation JWT complète, et logs expurgés des paramètres sensibles.
Voici une base pragmatique (à adapter) :
- Scopes minimaux (
openid email profile+ nécessité réelle) response_type=codeuniquement (pas d’implicite)- PKCE activé (
code_challenge_method=S256) stateimprévisible, stocké côté serveur, TTL courtnoncevérifié surid_token- Validation
id_token: signature +iss+aud+exp+nonce - Tokens stockés côté serveur, refresh token chiffré, rotation de clés
- Rate limiting et alerting sur endpoints OAuth
- Dashboards : succès/échec login, erreurs token, latence
Pour rendre la checklist “audit-proof”, ajoutez une colonne “preuve” (ce que vous montrez en revue) :
- Redirect URIs strictes → capture de config GCP + tests automatiques qui échouent si mismatch
- PKCE → logs applicatifs sans secrets indiquant
S256+ test d’intégration (verifier manquant = échec attendu) - Validation JWT → test unitaire avec JWT
audincorrect (doit être refusé) + lib OIDC documentée - Hygiène logs → règle explicite de masquage (
code,state,Authorization) + revue de configuration du reverse proxy
Si vous intégrez OAuth 2.0 Google dans un contexte e-commerce, pensez aussi au risque phishing et à la réduction de friction : les passkeys peuvent compléter (ou remplacer) certains scénarios de login, avec un gain sécurité/UX net : Passkeys e-commerce : réduire la friction et limiter le phishing.
Et si vous voulez une validation externe (spoiler : c’est souvent rentable comparé au coût d’un incident), faites auditer le design + l’implémentation : audit cybersécurité ou au minimum une revue de code orientée sécurité : revue et sécurisation de code. Parce que découvrir un bug OAuth en prod, c’est possible. Découvrir un bug OAuth pendant un audit de conformité, c’est une tradition beaucoup moins drôle.